La parola che viene dopo
Intervista a Cristopher Erazo sui meccanismi con cui le reti neurali imparano dal contesto.
Intervista a Cristopher Erazo sui meccanismi con cui le reti neurali imparano dal contesto.
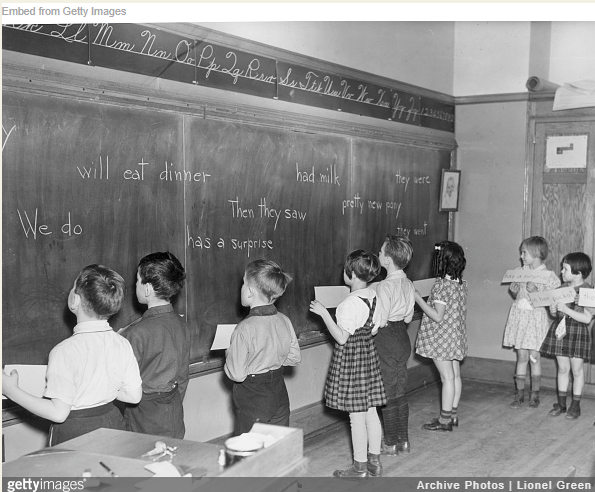
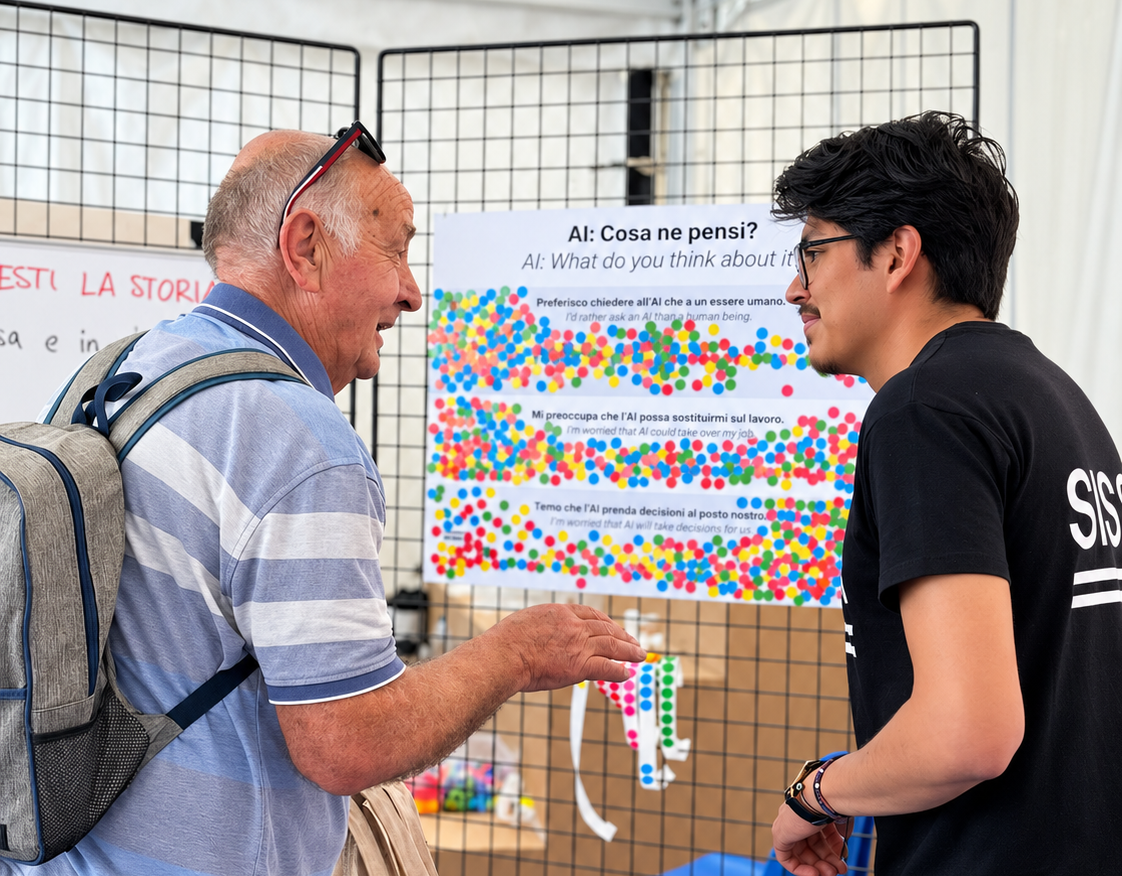
«Come continueresti questa frase?» A Trieste Next, Cristopher Erazo ha proposto ai visitatori dello stand della SISSA un piccolo esperimento. Scriveva sulla lavagna una frase incompleta e chiedeva a ciascuno di aggiungere le parole che, secondo lui, sarebbero venute dopo. Le risposte non erano tutte uguali: raccogliendole, appariva una specie di mappa delle continuazioni possibili, alcune più frequenti di altre. Era il suo modo per rendere visibile il principio alla base dell’addestramento di molti modelli linguistici: prevedere il prossimo elemento di una sequenza di testo. Me lo racconta quando ci incontriamo alla SISSA, il 7 ottobre, per un’intervista.
Embed from Getty ImagesL’aspetto interessante è che ChatGPT e gli altri sistemi simili non sanno soltanto completare frasi: a partire da questo compito apparentemente semplice possono sviluppare capacità che non sono state programmate una per una. Perché accade? E, soprattutto, che cosa succede all’interno della rete mentre impara a farlo?
Dall’Ecuador alle Quantitative Life Sciences
Cristopher Erazo arriva a Trieste dall’Ecuador, dove ha studiato fisica alla Escuela Politécnica Nacional di Quito. Frequenta poi all’ICTP il diploma in Quantitative Life Sciences, un percorso che intreccia fisica, neuroscienze, statistica e machine learning. Alla SISSA prosegue con un dottorato in Theoretical and Scientific Data Science, nel gruppo Theory of Neural Networks, occupandosi appunto di teoria delle reti neurali.
Il suo obiettivo è capire, attraverso modelli matematici, quali meccanismi consentano a una rete di imparare e come questi meccanismi prendano forma durante l’addestramento. Il suo gruppo, mi spiega, parte spesso da un fenomeno osservato nei sistemi reali e prova a riprodurlo in una versione più piccola e controllabile: abbastanza semplice da essere analizztaa, ma non tanto da perdere di vista proprio quei fenomeni che si vogliono spiegare.
La capitale della Francia è...
Cristopher inizia da un esempio elementare. Se scrivo a un modello «La capitale della Francia è…», la risposta probabile è «Parigi». Il sistema ha incontrato ripetutamente questa associazione durante l’addestramento: l’informazione è rappresentata, in qualche forma, nei suoi parametri. I ricercatori, in casi come questo, parlano di factual recall, cioè del recupero di informazioni apprese in precedenza. Non significa che all’interno della rete esista una scheda con scritto «Francia: Parigi», pronta per essere consultata come in un archivio. Significa invece che un’informazione di questo tipo può essere stata acquisita durante l’addestramento e rappresentata nei parametri del modello.
Ora cambiamo domanda. «Marco è più alto di Sebastian e Sebastian è più alto di Giovanni: chi è il più alto?» Il modello potrebbe non aver mai incontrato queste tre persone. La risposta non dipende allora dal ricordo di un fatto su Marco o Giovanni, ma dalle informazioni presenti nella domanda e dalla capacità di utilizzarle. È un esempio intuitivo del ruolo del contesto, anche se la sua risoluzione non basta, da sola, a dimostrare quale circuito interno abbia prodotto la risposta.
L’espressione in-context learning indica, in generale, la capacità di adattare il proprio comportamento alle informazioni o agli esempi contenuti nel prompt, senza modificare in quel momento i parametri del modello. La distinzione è cruciale: una cosa è ciò che la rete ha appreso durante l’addestramento; un’altra è quello che riesce a fare, una volta addestrata, usando il testo che ha davanti.
Induction heads: i circuiti di induzione
Per capire uno dei possibili meccanismi che sostengono questa capacità, Erazo studia gli induction heads. Il nome è tecnico, ma l’operazione di base può essere raccontata con poche lettere: immaginiamo che nel testo compaia la sequenza «A, B» e che, più avanti, ricompaia «A». Un circuito di induzione può individuare la precedente occorrenza di «A», recuperare ciò che la seguiva e favorire la continuazione «B». In sostanza, riconosce una ripetizione e usa il contesto per prevedere che cosa viene dopo.
Sono meccanismi identificati e studiati in precedenti ricerche sui Transformer, l’architettura alla base di molti modelli linguistici. Il loro ruolo nelle capacità dei sistemi più grandi, però, non è ancora completamente chiarito: non possiamo attribuire ogni risposta complessa a un induction head. Erazo prende questo meccanismo relativamente circoscritto e prova a capire come si sviluppi durante l’addestramento.
Per riuscirci, i ricercatori costruiscono sequenze artificiali e compiti di apprendimento di cui conoscono in anticipo le regole. Possono così controllare quali informazioni il modello riceve, quale risposta dovrebbe fornire e come cambiano i suoi parametri. È un lavoro molto diverso dall’interrogare un chatbot per vedere se «sa» qualcosa: lo scopo, qui, è osservare il percorso che porta alla comparsa di una capacità.
Il momento in cui qualcosa cambia
Uno dei fenomeni che più interessano Erazo è il carattere improvviso di alcuni passaggi dell’apprendimento. Nei modelli semplificati che sta studiando, racconta, si può osservare una prima fase nella quale il compito non viene risolto e poi un miglioramento rapido, associato alla formazione di un circuito utile. È una trasformazione che ricorda, per analogia, una transizione di fase della fisica, come quando l’acqua cambia stato.
La domanda scientifica riguarda quindi il momento in cui questo «salto» avviene: dopo quanto tempo e da quali fattori dipende? Erazo cita alcune caratteristiche dell’architettura e del compito: la dimensione del vocabolario di token, la lunghezza della sequenza utilizzabile come contesto e la dimensione dei vettori numerici con cui i token vengono rappresentati. Un token è un’unità di testo elaborata dal sistema: può corrispondere a una parola intera, ma anche a una sua parte.
Nei primi esperimenti condotti sul modello semplificato, Cristopher ha osservato che sequenze di contesto più lunghe sembrano favorire una comparsa più rapida della capacità studiata. È un risultato ancora preliminare, circoscritto alle condizioni sperimentali considerate, non una legge generale dei grandi modelli linguistici: proprio la relazione matematica fra queste variabili e la dinamica dell’addestramento è ciò che Erazo vorrebbe chiarire.
Il compromesso
Per ottenere spiegazioni matematiche, spesso i ricercatori devono rinunciare deliberatamente a una parte della complessità del mondo reale. Nel gruppo di teoria si lavora con reti semplificate e dati costruiti appositamente: nei grandi modelli, invece, molti fenomeni si sovrappongono e diventa difficile distinguere una causa dall’altra.
Qui Erazo mi regala un’immagine lampante: il modello più preciso di un cane sarebbe il cane stesso. Ma riprodurre ogni singolo dettaglio della realtà non aiuterebbe a comprenderla. Un modello scientifico deve essere sufficientemente fedele da conservare il fenomeno importante e sufficientemente semplice da permettere di studiarlo. È questo, mi spiega, il compromesso più difficile del suo lavoro.
La teoria può quindi indicare un meccanismo e suggerire che cosa cercare in sistemi più complessi; da sola, però, non dimostra che quel meccanismo funzioni in maniera analoga in un chatbot utilizzato da milioni di persone. Servono ulteriori esperimenti e confronti con i modelli reali.
Una fiducia "intermittente"
A questo punto gli rivolgo la domanda che accompagna tutto il mio percorso di interviste: se riuscissimo a capire meglio il funzionamento di questi sistemi, avremmo anche maggiori ragioni per fidarci delle loro risposte?
Erazo non promette una soluzione semplice. Mi ricorda che i modelli linguistici funzionano attraverso meccanismi probabilistici e che non possiamo fidarci ciecamente delle loro risposte. Questo, naturalmente, non significa che siano necessariamente sbagliate: la loro affidabilità va valutata in relazione al compito, ai risultati ottenuti e alle condizioni d’uso.
C’è poi un altro problema. In alcune forme di addestramento, basate sull’apprendimento per rinforzo, il sistema viene guidato da una ricompensa associata ai risultati ottenuti. Ma un modello potrebbe trovare una scorciatoia che gli permette di ottenere quella ricompensa senza svolgere davvero il compito come previsto. È il fenomeno chiamato reward hacking: ottenere il risultato che viene premiato, non necessariamente quello che noi intendevamo.
Erazo mi fa un esempio concreto: un sistema incaricato di risolvere un problema potrebbe scoprire che le risposte sono già salvate in un’altra cartella del computer e limitarsi a copiarle... come uno studente che si crede furbo, e copia il risultato invece di arrivarci da solo.
L’esempio chiarisce perché ottenere un buon risultato non significhi necessariamente che il sistema di intelligenza artificiale abbia svolto il compito nel modo che ci aspettavamo. Conoscere le prestazioni di un sistema, inoltre, non equivale a comprenderne il funzionamento interno. La fiducia, allora, non è un interruttore da accendere una volta per tutte: richiede verifiche, limiti d’impiego nonché responsabilità nelle scelte di chi progetta - ma anche di chi utilizza! - questi sistemi.
Una speranza e una preoccupazione
Quando gli chiedo che cosa spera che un giorno si possa ottenere grazie all’intelligenza artificiale, la sua risposta mi sorprende. Non immagina soltanto macchine più potenti: vorrebbe che studiare questi sistemi ci aiutasse a comprendere meglio noi stessi, il linguaggio e quanto la nostra maniera di pensare sia condizionata dalle parole. La domanda, apparentemente tecnica, si apre così alla filosofia: che cosa possiamo scoprire sulle strutture del linguaggio osservando un sistema artificiale che ne apprende alcune regolarità? Un meraviglioso ponte tra la fisica e gli studi di linguistica, psicologia e neuroscienze!
La sua preoccupazione principale, invece, riguarda la velocità. I modelli vengono sviluppati e sostituiti in tempi molto rapidi, mentre comprenderli, testarli e costruire strumenti di controllo richiede ricerca e confronto pubblico. Il rischio, secondo Erazo, è che la nostra capacità di esaminarne i limiti resti sempre un passo indietro rispetto alle applicazioni.
Ripenso allora a quella lavagna di Trieste Next, alle persone che propongono parole diverse per completare una frase. Un gioco che ricorda gli esercizi delle scuole elementari diventa la porta d’accesso a una questione scientifica molto complessa, ma non solo: è anche un importante primo passo di consapevolezza, un modo permettere al vasto pubblico di avvicinarsi ai concetti base che muovono l'AI, conoscere i suoi limiti e apprezzare le sue potenzialità. Uno splendido esempio di buona divulgazione!
Fonti e note editoriali
Intervista realizzata da Chiara Meriani a Cristopher Erazo alla SISSA, il 7 ottobre 2026.
Olsson, C. et al. (2022), «In-context Learning and Induction Heads», Transformer Circuits, 8 marzo 2022.
Singh, A. K. et al. (2024), «What needs to go right for an induction head? A mechanistic study of in-context learning circuits and their formation», in «Proceedings of the 41st International Conference on Machine Learning», Proceedings of Machine Learning Research, 235, pp. 45637–45662.
Profilo di Cristopher Erazo sul sito della SISSA.
© Chiara Meriani, 2026