Affidabilità
Machine learning e produzione della conoscenza
Tratto dalla tesi di Chiara Meriani per il Master di I livello in Filosofia del digitale e intelligenza artificiale. Comunicazione, economia e società. Università di Udine.
Dal tirocinio alla domanda di ricerca
La mia domanda di tirocinio è stata accolta da Roberto Trotta, professore ordinario di Fisica teorica alla SISSA di Trieste, direttore del Laboratorio Interdisciplinare per le Scienze Naturali e Umanistiche (ILAS) e responsabile della Data Science alla SISSA. Visto il mio interesse di ricerca, mi ha suggerito di seguire il lavoro di Sebastian Goldt, professore associato alla stessa Scuola Internazionale, dove dirige il gruppo di ricerca Theory of Neural Networks. È un fisico specializzato nello studio dei meccanismi di apprendimento delle reti neurali artificiali.
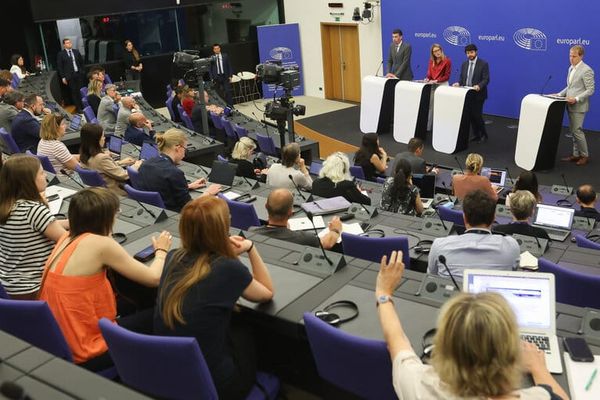
Uno dei primi eventi a cui ho partecipato durante il tirocinio è stato Youth in High-Dimensions: Recent Progress in Machine Learning, High-Dimensional Statistics and Inference. Dal 20 al 23 luglio 2026 l’ICTP di Trieste, International Centre for Theoretical Physics, ha ospitato quattro giornate di seminari dedicati alle frontiere della ricerca nel campo del machine learning, della statistica ad alta dimensionalità e dell’inferenza, con particolare attenzione allo studio delle reti neurali e ai fondamenti teorici dell’apprendimento automatico. (ICTP, 2026).
La domanda che mi incuriosiva, non era tanto che cosa le reti neurali fossero in grado di fare: ma come ci riuscissero. Ed è esattamente la domanda attorno alla quale giravano molti dei panel proposti da giovani ricercatori internazionali. Tra questi, ho scelto per la mia prima intervista Romain Cosson, assistant Professor e Faculty Fellow in Computer Science al Courant Institute of mathematical Sciences della New York University.
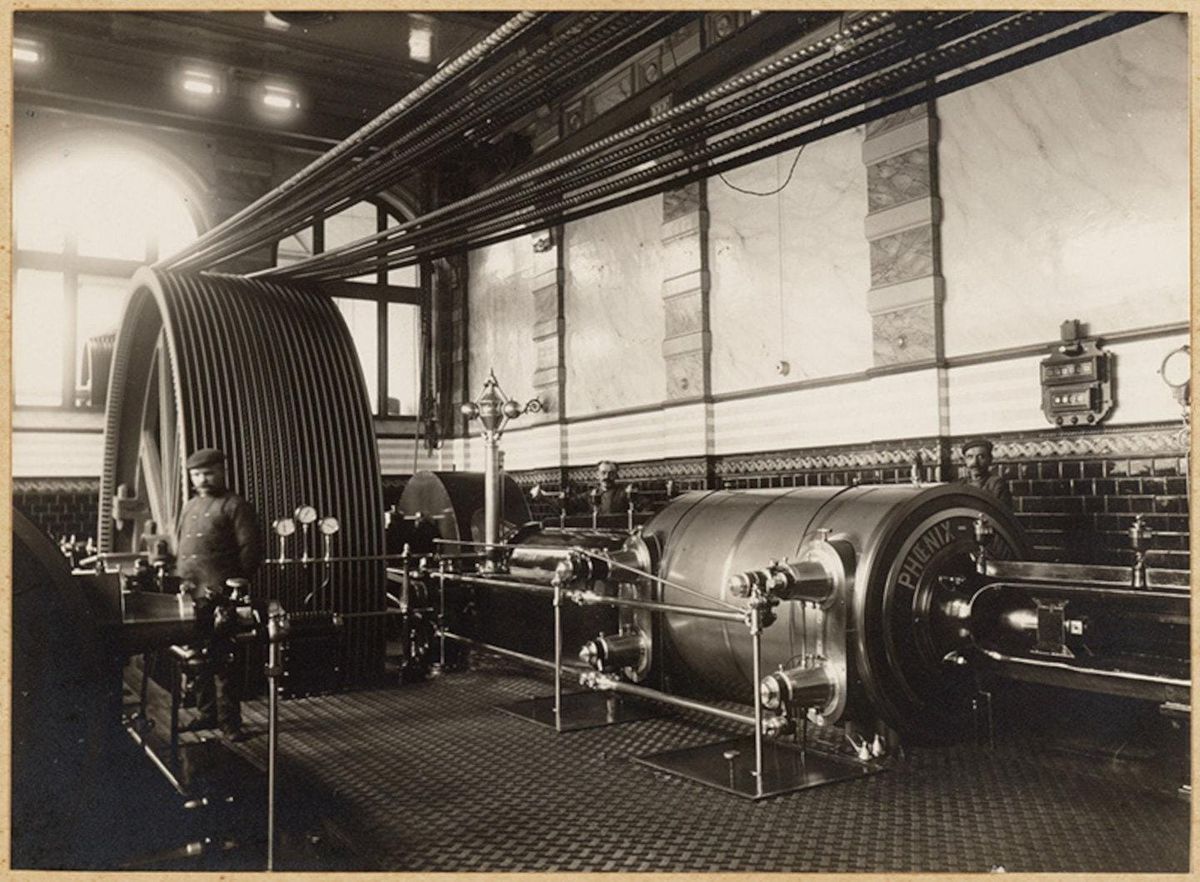
A conclusione della sua lecture, parlando del rapporto fra prestazioni e teoria, mi ha descritto un’immagine che mi è rimasta in mente: all’inizio della rivoluzione industriale i motori a vapore funzionavano già, mentre la teoria capace di descriverne il funzionamento arrivò dopo. Oggi, suggeriva, potremmo trovarci in una situazione in parte simile: abbiamo costruito sistemi sorprendenti, ma non possediamo ancora una spiegazione generale di tutto ciò che accade durante il loro apprendimento.
L’analogia, naturalmente, non dimostra che la storia del machine learning ripeterà quella della termodinamica. Ma è interessante, per la domanda che lascia aperta: che cosa significa affidarsi a un sistema quando sappiamo che funziona in certe condizioni, ma non sappiamo ancora spiegare fino in fondo perché funzioni o quando smetterà di farlo? È una domanda che attraversa la ricerca scientifica, ma non rimane confinata nei laboratori. Oggi, ogni volta che un risultato prodotto o suggerito da un sistema di intelligenza artificiale viene usato per decidere, insegnare, pubblicare o raccontare, ci dev’essere qualcuno in grado di valutarne la portata e rispondere delle conseguenze.
La tesi nasce da questo scarto: da una parte risultati osservabili, modelli che classificano, generano, prevedono o suggeriscono ipotesi; dall’altra la necessità di capire che cosa autorizzi a credere a un risultato, ad usarlo e a comunicarlo. La domanda «ci si può fidare dell’intelligenza artificiale?» sembra esigere un sì o un no. In realtà, per poter rispondere, occorre specificare di quale sistema, compito, prova e contesto si stia parlando. Un sistema può essere valutato diversamente quando risponde a una domanda scientifica circoscritta da quando è invitato a dare consigli di vita. Non perché il primo genere di domanda sia, per “la macchina”, più semplice o il secondo privo di qualsiasi criterio; ma perché il significato di “risposta corretta” non è lo stesso.
Dal risultato alla fiducia: scienza, divulgazione e giornalismo
Nell’intervista realizzata durante Youth in High-Dimensions, Romain Cosson distingue i problemi per i quali esiste una risposta verificabile da quelli riguardanti scelte personali, dove può mancare una “verità di riferimento” con cui confrontare l’output. Ma nemmeno la presenza di una ground truth assicura di poter valutare l’output: il risultato infatti ha significato soprattutto perché è il risultato di un processo.
La distinzione emerge in un esempio più tecnico raccontato da Cosson: un algoritmo potrebbe arrivare al numero giusto e, allo stesso tempo, accompagnarlo con una dimostrazione sbagliata. Il risultato corretto non certifica da solo il percorso che lo ha prodotto. Se il compito richiede una spiegazione, una prova o la possibilità di controllare il ragionamento, non basta guardare soltanto alla risposta finale: il modo in cui il risultato è stato ottenuto può essere quindi parte della sua affidabilità.
Il confronto con l’intelligenza umana richiede allora una cautela ulteriore. Dire che un modello «impara», «ragiona» o «capisce» può essere utile per descriverne il comportamento, ma non dimostra che segua i processi di una mente umana. La somiglianza di una prestazione non basta a stabilire una somiglianza di funzionamento: per giudicare un sistema, dobbiamo prima chiarire quale capacità stiamo misurando e con quali prove.
La domanda cambia ancora quando il sistema non offre una risposta, ma suggerisce dove cercare. L’utilità del “suggerimento” diventa centrale durante un’altra intervista, fatta a Michael Skinnider, vincitore del Premio ICTP-IBM Brahmagupta 2026 per l’intelligenza artificiale.
Michael è biologo computazionale e Assistant Professor al Lewis-Sigler Institute for Integrative Genomics e alla Ludwig Princeton Branch della Princeton University. Medico e ricercatore, guida un laboratorio che sviluppa metodi di machine learning per identificare molecole ancora sconosciute e studiarne il ruolo nella salute e nelle malattie. In particolare, il gruppo dei ricercatori guidati dal prof. Skinnider ha ideato DeepMet, un chemical language model: un modello linguistico applicato alla chimica, addestrato sulle strutture di metaboliti già conosciuti, per prevedere l'esistenza di molecole non ancora identificate: la cosiddetta “materia oscura del corpo”. (Qiang et al., 2026).
Il risultato è particolarmente interessante: combinando DeepMet con i dati della spettrometria di massa, i ricercatori hanno identificato diverse decine di metaboliti precedentemente sconosciuti: gli autori dello studio riferiscono la scoperta complessiva di 36 metaboliti attraverso diverse procedure e livelli di conferma sperimentale. Il paper distingue identificazioni confermate, corrispondenze provvisorie e sostanze già note ma assenti dai database. La ricerca è stata pubblicata su Nature il 14 gennaio 2026, con il titolo «Language model-guided anticipation and discovery of mammalian metabolites»: un esempio chiaro, per dire che l'IA non si limita a riorganizzare conoscenze esistenti, ma può contribuire alla produzione di nuova conoscenza scientifica, purché le sue previsioni siano sottoposte a verifica sperimentale. (Qiang et al., 2026).
Michael Skinnider mi spiega infatti l’utilizzo di DeepMet come parte di un processo: il modello propone strutture chimiche candidate; la ricerca le mette alla prova; la sintesi e i confronti sperimentali aggiungono verifiche. Una struttura suggerita non è ancora una molecola identificata in un campione: la fiducia, in questo caso, si “aggiorna” nella fase sperimentale.
Come nella scienza, anche nella divulgazione scientifica e nel lavoro giornalistico in genere, la fiducia gioca un ruolo fondamentale: in ognuno di questi ambiti, i fatti (dimostrabili) sono sempre stati centrali nella produzione di conoscenza. Oggi che gran parte della comunicazione è diventata generativa, sorgono domande non solo filosofiche ma anche pratiche, soprattutto di ordine legale; ma anche questioni legate a qualità, efficienza e sicurezza, questioni che investono molti ambiti sia professionali che sociali.
Scopo di questa tesi è indagare il concetto di fiducia legato in particolare alla produzione di conoscenza, ed alla sua divulgazione, nell’era in cui la conoscenza stessa viene realizzata anche attraverso tecniche di machine learning e Large Language Models. La domanda centrale può quindi essere così formulata: su quali basi può fondarsi la fiducia nei processi di produzione e comunicazione della conoscenza sostenuti dal machine learning?
La formulazione tiene conto di due aspetti, senza confonderli: le ragioni per considerare attendibile un risultato, prodotto o supportato da un modello; e quelle per considerare corretto il racconto che ne arriva al pubblico.
Sull’affidabilità dei modelli
Una prima distinzione necessaria è quella tra affidabilità e fiducia. L’affidabilità tecnica riguarda ciò che un sistema riesce a fare in condizioni definite: il compito, i dati, i criteri di valutazione, il margine d’errore. La fiducia riguarda anche il modo in cui quel risultato viene utilizzato: possiamo conoscere la prestazione media di un modello e non sapere se sia adatto alla situazione che abbiamo davanti; possiamo ricevere un output corretto e non disporre di elementi sufficienti per capire se sia stato raggiunto per una ragione pertinente; possiamo affidarci a una procedura ma avere bisogno di sapere chi interviene quando qualcosa va storto. Il vocabolario Treccani dà questa definizione:
affidabilità s. f. [der. di affidabile]. – Nel linguaggio tecn. (come traduz. dell’ingl. reliability), la garanzia che un impianto, un apparecchio, un organo dà di funzionare correttamente. (Treccani, voce «affidabilità»).
In questo momento storico in cui le cosidette black-box stanno entrando sempre più a far parte della società, anche con ruoli decisionali oltreché generativi, è fondamentale comprendere innanzitutto l'affidabilità di questi modelli: cerchiamo allora di capire se ci siano certezze su cui far affidamento, o se il carattere probabilistico dell’intelligenza artificiale renda impossibile ottenere garanzie di funzionamento corretto.
Sorge così una questione epistemologica: per fidarci di un risultato dobbiamo necessariamente saper spiegare il meccanismo che lo ha prodotto? Una prestazione misurata e ripetibile offre evidenze sul comportamento di un sistema, ma non esaurisce la domanda sul perché funzioni; una spiegazione convincente, a sua volta, non sostituisce la verifica delle prestazioni. La fiducia, quindi, non può dipendere soltanto dal fatto che una macchina sia più o meno efficiente e trasparente: occorre precisare quali prove possediamo, che cosa permettono di concludere e che cosa resta incerto.
La prima domanda necessaria è se si possa misurare, concretamente, l'affidabilità di una rete neurale. Per cercare una risposta, ho dovuto fare un passo indietro e partire da una questione apparentemente più semplice: che cosa significa, per una macchina, imparare?
La risposta è arrivata da Rudy Skerk, dottorando in fisica e coautore di uno studio realizzato in collaborazione con l'ICTP e l'Università di Bologna, pubblicato il 22 luglio 2026 su Physical Review X. La ricerca affronta uno dei problemi fondamentali del machine learning: comprendere come le reti neurali apprendano dai dati e, soprattutto, in quali condizioni riescano ad applicare a situazioni nuove ciò che hanno già imparato. È il concetto di generalizzazione, uno degli elementi fondamentali per valutare l'affidabilità di un sistema di apprendimento automatico. (Barbier et al., 2026).
Per comprendere il concetto di generalizzazione nel machine learning, può essere utile un parallelismo con l’essere umano. Un bambino impara a riconoscere un gatto: all'inizio vede il gatto di famiglia, ad esempio, e gli viene insegnato che quell'animale è un gatto. Poi ne incontra uno diverso: piccolo anziché grande, nero anziché bianco, con il pelo corto anziché lungo. Eppure riesce a riconoscerlo come appartenente alla stessa categoria. Il bambino ha imparato ad estrarre alcune caratteristiche e relazioni che gli permettono di estendere ciò che sa a nuovi esempi.
Questa è una forma di generalizzazione per categorie. Ma negli esseri umani esistono anche forme più complesse di generalizzazione: per esempio, un ragazzo che ha imparato a risolvere un problema matematico può riconoscere la stessa struttura in un esercizio completamente diverso. Oppure una persona che si è scottata toccando una pentola bollente può utilizzare quell'esperienza per evitare di toccare un altro oggetto che riconosce come molto caldo. In questi casi generalizzare non significa soltanto riconoscere somiglianze, ma anche trasferire regole, relazioni o conoscenze da un'esperienza all'altra.
Dal punto di vista delle scienze cognitive, la generalizzazione umana coinvolge diversi processi: il riconoscimento di regolarità, la formazione di categorie e concetti, il ragionamento per analogia e la capacità di utilizzare conoscenze precedenti per interpretare situazioni nuove. Un aspetto particolarmente interessante è che gli esseri umani possono talvolta ricavare generalizzazioni complesse anche da pochissimi esempi, grazie alle conoscenze che possiedono già. Ma, naturalmente anche noi esseri umani possiamo generalizzare male, attribuendo a un'intera categoria una caratteristica osservata in pochi casi, applicando una regola dove non funziona oppure riconoscendo somiglianze superficiali ma trascurando differenze importanti. E’ anche così che nascono i pregiudizi, i famosi bias, ben prima nell’essere umano che nella “macchina”. Eppure, è grazie alla generalizzazione che possiamo “sopravvivere”.
Rispetto alle reti neurali, la somiglianza sta soprattutto nel problema da risolvere: utilizzare l'esperienza precedente per affrontare qualcosa di nuovo. Non significa però che cervello e rete neurale impieghino gli stessi meccanismi: generalizzare, per la macchina, non significa necessariamente comprendere nel senso umano del termine. Che cosa sta facendo dunque l’intelligenza artificiale, quando generalizza?
Partiamo dalla distinzione tra imparare e memorizzare: anche qui l’analogia umana può aiutarci a capire che cosa accade nel machine learning. Pensiamo ad uno studente che si prepara per un esame: potrebbe imparare a memoria tutte le risposte agli esercizi del libro e ottenere un ottimo risultato, purché durante l'esame gli vengano proposti proprio quegli esercizi. Ma che cosa accadrebbe davanti a un problema nuovo? Se ha compreso la regola che permette di risolverlo, saprà applicarla anche in una situazione mai incontrata prima. Altrimenti, probabilmente, si troverà in difficoltà.
Qualcosa di simile può accadere alle reti neurali. Un modello può ottenere risultati eccellenti sui dati utilizzati durante l'addestramento e commettere molti errori quando viene messo alla prova con dati nuovi. È il problema dell'overfitting: il sistema si adatta eccessivamente agli esempi che conosce, comprese eventuali particolarità che non si ripresentano altrove.
Per studiare questo fenomeno, Skerk e i suoi colleghi utilizzano un modello teorico chiamato teacher-student, o rete maestra e rete allieva. La prima genera esempi secondo una struttura matematica conosciuta dai ricercatori; la seconda deve imparare dai dati ricevuti, senza poter osservare direttamente i parametri nascosti della rete maestra. In questo modo diventa possibile verificare non soltanto quanto bene l'allieva risponda, ma anche in quale misura riesca a recuperare le caratteristiche della rete che ha generato i dati.
Il modello studiato è un multilayer perceptron, una rete neurale a più strati. Non è un Large Language Model come quelli che utilizziamo nei chatbot, ma appartiene alla famiglia di architetture che contribuiscono al loro funzionamento. La semplificazione permette agli scienziati di studiare matematicamente alcuni fenomeni che, in sistemi molto più grandi e complessi, sarebbero assai più difficili da isolare. Il paper mostra, nelle condizioni teoriche considerate, come l'apprendimento possa attraversare fasi differenti, nelle quali la rete recupera progressivamente caratteristiche della struttura che deve imparare.
È qui che Skerk introduce un fenomeno particolarmente interessante: la transizione di apprendimento, che la fisica statistica permette di studiare in modo simile a una transizione di fase. Pensiamo all’acqua che, raggiunte determinate condizioni, passa dallo stato liquido a quello solido: non cambia soltanto la temperatura, cambia il suo stato. Anche nel modello maestro-allieva studiato possono emergere, all’aumentare dei dati, passaggi fra regimi differenti. A un certo punto diventa possibile una maggiore specializzazione: alcuni parametri della rete allieva si allineano con quelli della maestra e migliora la capacità di generalizzare. È il momento in cui, con una metafora, potremmo dire che la rete finalmente «coglie il succo». Ma ovviamente non significa che abbia capito nel senso umano del termine, né che tutte le reti neurali imparino attraverso gli stessi passaggi. (Barbier et al., 2026, pp. 4–5 e 11–12).
Un fenomeno collegato mi è stato spiegato da Cristopher Erazo, durante un’intervista realizzata alla SISSA. Insieme ad altri ricercatori, studia modelli Transformer semplificati e cerca di capire come si formino gli induction heads: particolari circuiti associati alla capacità di utilizzare le informazioni contenute nel contesto di una domanda, il cosiddetto in-context learning. Erazo descrive una prima fase di ricerca, o search phase, seguita da una transizione rapida: il modello sviluppa il circuito necessario e comincia a risolvere il compito costruito dai ricercatori. Anche qui sembra quasi che ad un certo punto si accenda una lampadina. Ma il parallelismo con Skerk è da prendere con le pinze: si tratta di modelli, problemi e risultati diversi; e la spiegazione teorica completa di questa dinamica nei Transformer è ancora oggetto di ricerca. (Erazo, intervista dell’autrice, 7 ottobre 2026, p. 7). Nel lavoro di Skerk, d’altra parte, le transizioni sono soltanto uno degli aspetti che emergono dall’analisi. Si evidenzia anche un'altra questione: il migliore risultato teoricamente possibile non coincide necessariamente con quello che gli algoritmi di addestramento riescono effettivamente a raggiungere. Le informazioni necessarie potrebbero essere disponibili nei dati, senza che il metodo utilizzato riesca a sfruttarle in modo ottimale. I libri sono sugli scaffali della biblioteca, ma lo studente non riesce a trovarli.
Per l'affidabilità, questa distinzione è fondamentale: non basta sapere che un modello può raggiungere una determinata prestazione: dobbiamo anche verificare se l'ha effettivamente raggiunta, su quali dati, con quale margine d'errore e in quali condizioni. Quando sappiamo misurare le prestazioni di una rete, rimane quindi aperta un'altra domanda: che cosa ha imparato realmente? Quali informazioni ha utilizzato per arrivare alla risposta?
È uno degli interrogativi al centro della ricerca di Fabiola Ricci. Nel paper «A Fourier perspective on the learning dynamics of neural networks: from sample complexities to mechanistic insights», realizzato insieme a Claudia Merger e Sebastian Goldt, Ricci studia il modo in cui le reti neurali apprendono le caratteristiche statistiche delle immagini. (Ricci, Merger e Goldt, 2026). Un concetto importante è quello di simplicity bias: in determinati contesti, le reti tendono ad apprendere prima regolarità statistiche relativamente semplici e successivamente informazioni più complesse. Attenzione, però: ciò che è semplice per una rete neurale non coincide necessariamente con ciò che è semplice per noi.
Nello studio, i ricercatori utilizzano la trasformata di Fourier, uno strumento matematico che permette di rappresentare le immagini attraverso componenti chiamate ampiezza e fase. Nelle condizioni analizzate, le ampiezze sono associate a correlazioni statistiche più semplici, mentre le fasi permettono di descrivere strutture più complesse, importanti anche per il riconoscimento dei contorni. Come capire quali informazioni la rete utilizza davvero? I ricercatori hanno addestrato un modello a distinguere immagini di diverse texture come cotone e pizzo e successivamente hanno modificato artificialmente alcune proprietà delle immagini, scambiando le informazioni di fase. Osservando come cambiano le prestazioni durante l'addestramento, hanno trovato evidenze che la rete sfrutta inizialmente le informazioni di ampiezza e soltanto in seguito quelle di fase.
Un risultato particolarmente interessante è che, nelle condizioni studiate, le informazioni statistiche più semplici possono facilitare l'apprendimento di quelle più complesse, anche quando non sono sufficienti, da sole, per risolvere il problema di classificazione.
Questo significa che, per comprendere il funzionamento di una rete, può essere necessario intervenire sui dati e verificare come cambia il suo comportamento. La ricerca offre quindi un esempio concreto di come sia possibile indagare alcuni meccanismi interni delle reti neurali. Naturalmente non dimostra che tutte le reti apprendano sempre nello stesso ordine, né fornisce una spiegazione generale del funzionamento degli LLM; ma contribuisce a trasformare una black box in un oggetto di studio del quale possiamo cominciare a descrivere, e in parte prevedere, alcuni comportamenti. (Ricci, Merger e Goldt, 2026).
Il problema ovviamente diventa più complesso quando passiamo dalle reti utilizzate per classificare immagini ai grandi modelli linguistici. Anche qui ritorna una difficoltà già descritta da Erazo e Skerk: per spiegare il funzionamento di un sistema complesso bisogna semplificarlo. Ma fino a che punto possiamo farlo senza perdere proprio quel fenomeno che vogliamo comprendere?
Lo stesso vale per la fase di valutazione della performance di un modello, del suo output: Erazo infatti sottolinea un limite importante negli strumenti con cui valutiamo i modelli linguistici. I benchmark, test costruiti per misurare prestazioni in determinati compiti come la traduzione, la matematica o la risoluzione di problemi, sono indispensabili per confrontare i sistemi, ma possono misurare soltanto le capacità che i test sono progettati per rilevare. Un modello che ottiene ottimi risultati in un benchmark non diventa automaticamente affidabile in qualsiasi situazione: e una capacità emergente che non sappiamo ancora misurare potrebbe sfuggire alla nostra valutazione. (Erazo, intervista dell’autrice, 7 ottobre 2026).
Semplificazione e generalizzazione
Come abbiamo visto, una parte essenziale della ricerca scientifica consiste nel creare le condizioni in cui un fenomeno diventa osservabile e analizzabile. Una rete neurale reale può contenere un numero enorme di parametri e interagire con dati molto diversi fra loro: per capire che cosa accade, i ricercatori isolano un problema, costruiscono modelli più semplici, stabiliscono quali grandezze misurare. È il metodo che ho incontrato nelle ricerche di Skerk, Ricci ed Erazo, pur nella diversità dei loro obiettivi. Un esperimento controllato può dirci che una rete è riuscita a recuperare determinate caratteristiche dai dati, che durante l’addestramento ha cominciato a utilizzare un certo tipo di informazione, oppure che in condizioni particolari è comparso un comportamento prima assente. Ma il risultato appartiene, innanzitutto, al problema studiato. Non autorizza automaticamente una conclusione sull’intera famiglia delle reti neurali, e tanto meno su tutti i sistemi commerciali che oggi vengono chiamati di «intelligenza artificiale».
Prendiamo il lavoro di Ricci, Merger e Goldt: attraverso esperimenti e un modello matematico, il paper cerca di spiegare perché alcune caratteristiche statistiche vengano sfruttate prima di altre. Proprio qui appare una distinzione importante per chi legge un articolo scientifico: una parte dei risultati è dimostrata rigorosamente nel modello considerato; altre previsioni teoriche, relative al caso più complesso con spettri a legge di potenza, sono formulate come congetture: è il confine che gli autori tracciano fra ciò che hanno dimostrato e ciò che resta da dimostrare. (Ricci, Merger e Goldt, 2026, § 5; preprint arXiv:2605.16913v1).
Nel lavoro di Skerk e dei suoi colleghi emerge una cautela differente. Il miglior risultato teoricamente ottenibile con determinate informazioni non coincide necessariamente con quello che un algoritmo concreto riuscirà a trovare. È una differenza importante: la possibilità matematica di imparare non garantisce che, durante un addestramento reale, si trovi davvero la soluzione migliore. E nell’indagine di Erazo, che riguarda un’altra architettura e un altro problema, resta aperta la spiegazione completa delle condizioni nelle quali compaiono alcuni circuiti di apprendimento dal contesto. (Barbier et al., 2026; Erazo, intervista dell’autrice, 7 ottobre 2026)
Le tre ricerche, insomma, si avvicinano a un problema comune: passare dall’osservazione delle prestazioni dei modelli a una spiegazione dei meccanismi che producono quelle prestazioni. Una spiegazione che permetta di generalizzare.
Quello che ancora non sappiamo
Durante Youth in High-Dimensions, all’ICTP, la varietà delle ricerche presentate mi ha colpito quanto la loro complessità. Giovani matematici, fisici, informatici e studiosi di statistica affrontavano questioni differenti, usando metodi differenti. C’era chi cercava di capire come una rete impari, chi studiava il ruolo dei dati, chi provava a ricostruire la memoria e chi indagava comportamenti che emergono nel corso dell’addestramento: il ritratto di una scienza alle prese con un oggetto che si è sviluppato più rapidamente della teoria generale capace di descriverlo!
La storia del machine learning in realtà è molto più lunga di quanto la recente esplosione dell'intelligenza artificiale generativa potrebbe far pensare: le sue radici risalgono a oltre ottant'anni fa. Già nel 1943 Warren McCulloch e Walter Pitts avevano proposto un modello logico-matematico del neurone artificiale. Nel 1958 Frank Rosenblatt presentò il percettrone, un sistema capace di modificare le proprie connessioni per imparare dagli esempi. L'anno successivo Arthur Samuel pubblicò uno studio su un programma in grado di migliorare progressivamente le proprie prestazioni nel gioco della dama: il termine machine learning entrava così nella letteratura scientifica. (McCulloch e Pitts, 1943; Rosenblatt, 1958; Samuel, 1959).
Da allora, il percorso non è stato affatto lineare: periodi di entusiasmo si alternano a rallentamenti, difficoltà teoriche e limiti tecnologici. Nel 1986 un celebre lavoro di David Rumelhart, Geoffrey Hinton e Ronald Williams rilancia lo studio delle reti neurali multistrato, mostrando come addestrarle attraverso la backpropagation, la retropropagazione dell'errore. Poi, nel 2012, una rete neurale profonda ottiene risultati rivoluzionari nel riconoscimento delle immagini; nel 2017 viene presentata l'architettura Transformer, destinata a diventare fondamentale per i grandi modelli linguistici contemporanei. (Rumelhart, Hinton e Williams, 1986; Krizhevsky, Sutskever e Hinton, 2012; Vaswani et al., 2017).
Negli anni successivi, lo sviluppo accelera. Nel 2018 viene presentato BERT, un modello basato sui Transformer capace di apprendere rappresentazioni linguistiche considerando il contesto delle parole in entrambe le direzioni (Devlin et al., 2018). Nel 2020 GPT-3 dimostra come l'aumento delle dimensioni dei modelli possa migliorarne la capacità di affrontare compiti nuovi a partire da pochi esempi (Brown et al., 2020). Il 30 novembre 2022 OpenAI presenta ChatGPT, rendendo accessibile al grande pubblico un'interfaccia conversazionale basata sull'intelligenza artificiale generativa (OpenAI, 2022). Nel 2023 arriva GPT-4, un modello multimodale capace di elaborare anche immagini oltre al testo (OpenAI, 2023). Nel 2024 si affermano nuove direzioni di sviluppo, fra cui modelli addestrati a dedicare maggiore elaborazione ai compiti di ragionamento, come OpenAI o1. Nel 2025 la ricerca su DeepSeek-R1 mostra ulteriori possibilità dell'apprendimento per rinforzo nel migliorare le prestazioni su compiti complessi e verificabili (OpenAI, 2024; Guo et al., 2025).
Insomma… ChatGPT non è comparso dal nulla: è il risultato di decenni di ricerca, durante i quali matematica, statistica, informatica e neuroscienze hanno contribuito a costruire l’ “intelligenza artificiale”. Molte cose, dunque, già le sappiamo. Conosciamo il funzionamento di numerose architetture, i principi degli algoritmi di addestramento e diversi meccanismi attraverso i quali le reti apprendono dai dati. Possiamo misurarne le prestazioni, confrontare modelli differenti, osservare come reagiscono quando modifichiamo gli input e, in condizioni controllate, descrivere matematicamente alcuni processi di apprendimento. Quello che ancora ci manca è una teoria sufficientemente generale da spiegare e prevedere tutti i fenomeni che osserviamo, soprattutto nei sistemi più grandi e complessi.
Torniamo all’esempio della termodinamica. Già nel 1712 le macchine a vapore di Thomas Newcomen venivano utilizzate per pompare l’acqua dalle miniere. Nei decenni successivi James Watt ne migliorò notevolmente l’efficienza. Ma fu soltanto nel 1824 che Sadi Carnot pose le basi della moderna termodinamica, studiando i limiti teorici del rendimento dei motori termici. La tecnologia, dunque, funzionava già prima che la scienza disponesse di una teoria generale capace di descriverne le prestazioni e i limiti: la conoscenza pratica e la comprensione teorica procedevano a ritmi differenti.
Con l’intelligenza artificiale ci troviamo, per certi aspetti, in una situazione analoga. Si costruiscono e si utilizzano sistemi dalle prestazioni sorprendenti, mentre la scienza cerca di spiegare compiutamente alcuni dei meccanismi che producono quei risultati. Benché molti interrogativi teorici restino aperti, è urgente imparare ad usare i sistemi di intelligenza artificiale nel modo più corretto possibile: proprio come accadde con le macchine a vapore.
Precedente: Introduzione
Capitolo successivo: Credibilità.
La bibliografia verrà fornita a pubblicazione completata di tutti i capitoli della tesi. Stay tuned!